Ngày 15: Chỉ mục (index)
Tóm tắt: Chỉ mục (index) là cấu trúc dữ liệu phụ giúp PostgreSQL tìm dòng cần mà không phải đọc cả bảng. Bài này đo thật trên bảng 1 triệu đơn hàng để thấy index giúp được bao nhiêu, khi nào nó vô dụng, và cái giá phải trả khi ghi dữ liệu.
Sau bài này bạn có thể:
- Tạo, liệt kê và xóa index bằng
CREATE INDEX,pg_indexes,DROP INDEX. - Đo một truy vấn trước và sau khi tạo index bằng
EXPLAIN ANALYZEvà nhận ra truy vấn có dùng index hay không. - Chọn thứ tự cột cho index nhiều cột theo quy tắc tiền tố trái.
- Dùng UNIQUE index, partial index và expression index đúng chỗ.
- Giải thích vì sao index trên cột ít giá trị khác nhau thường vô dụng, và vì sao mỗi index làm
INSERTchậm đi.
Cần biết trước: Ngày 2 (khóa chính, khóa ngoại, UNIQUE), Ngày 3, Ngày 4, Ngày 6 (BEGIN ... ROLLBACK).
Index là gì?
Hãy nghĩ tới một cuốn sách 500 trang. Muốn tìm chỗ nói về "khóa ngoại", bạn có hai cách:
- Lật từng trang từ đầu tới cuối. Chắc chắn tìm được, nhưng lâu.
- Mở phần mục lục cuối sách: các từ khóa đã xếp theo thứ tự chữ cái, mỗi từ ghi số trang. Bạn tìm từ khóa trong vài giây rồi lật thẳng tới trang đó.
Bảng trong PostgreSQL giống cuốn sách: các dòng nằm trong file theo thứ tự được ghi vào, không theo customer_id hay order_date. Không có index, muốn tìm đơn của khách 4242, PostgreSQL phải đọc mọi dòng rồi giữ lại dòng khớp. Cách đọc này gọi là Sequential Scan (Seq Scan).
Index là "mục lục" đó: một cấu trúc riêng, lưu các giá trị của cột đã sắp xếp sẵn, mỗi giá trị kèm vị trí của dòng trong bảng. Kiểu index mặc định của PostgreSQL là B-tree (cây cân bằng): từ nút gốc, mỗi bước đi xuống loại bỏ được phần lớn các khóa không liên quan, nên dù bảng có hàng triệu dòng cũng chỉ cần vài bước là tới nút lá chứa khóa cần tìm.
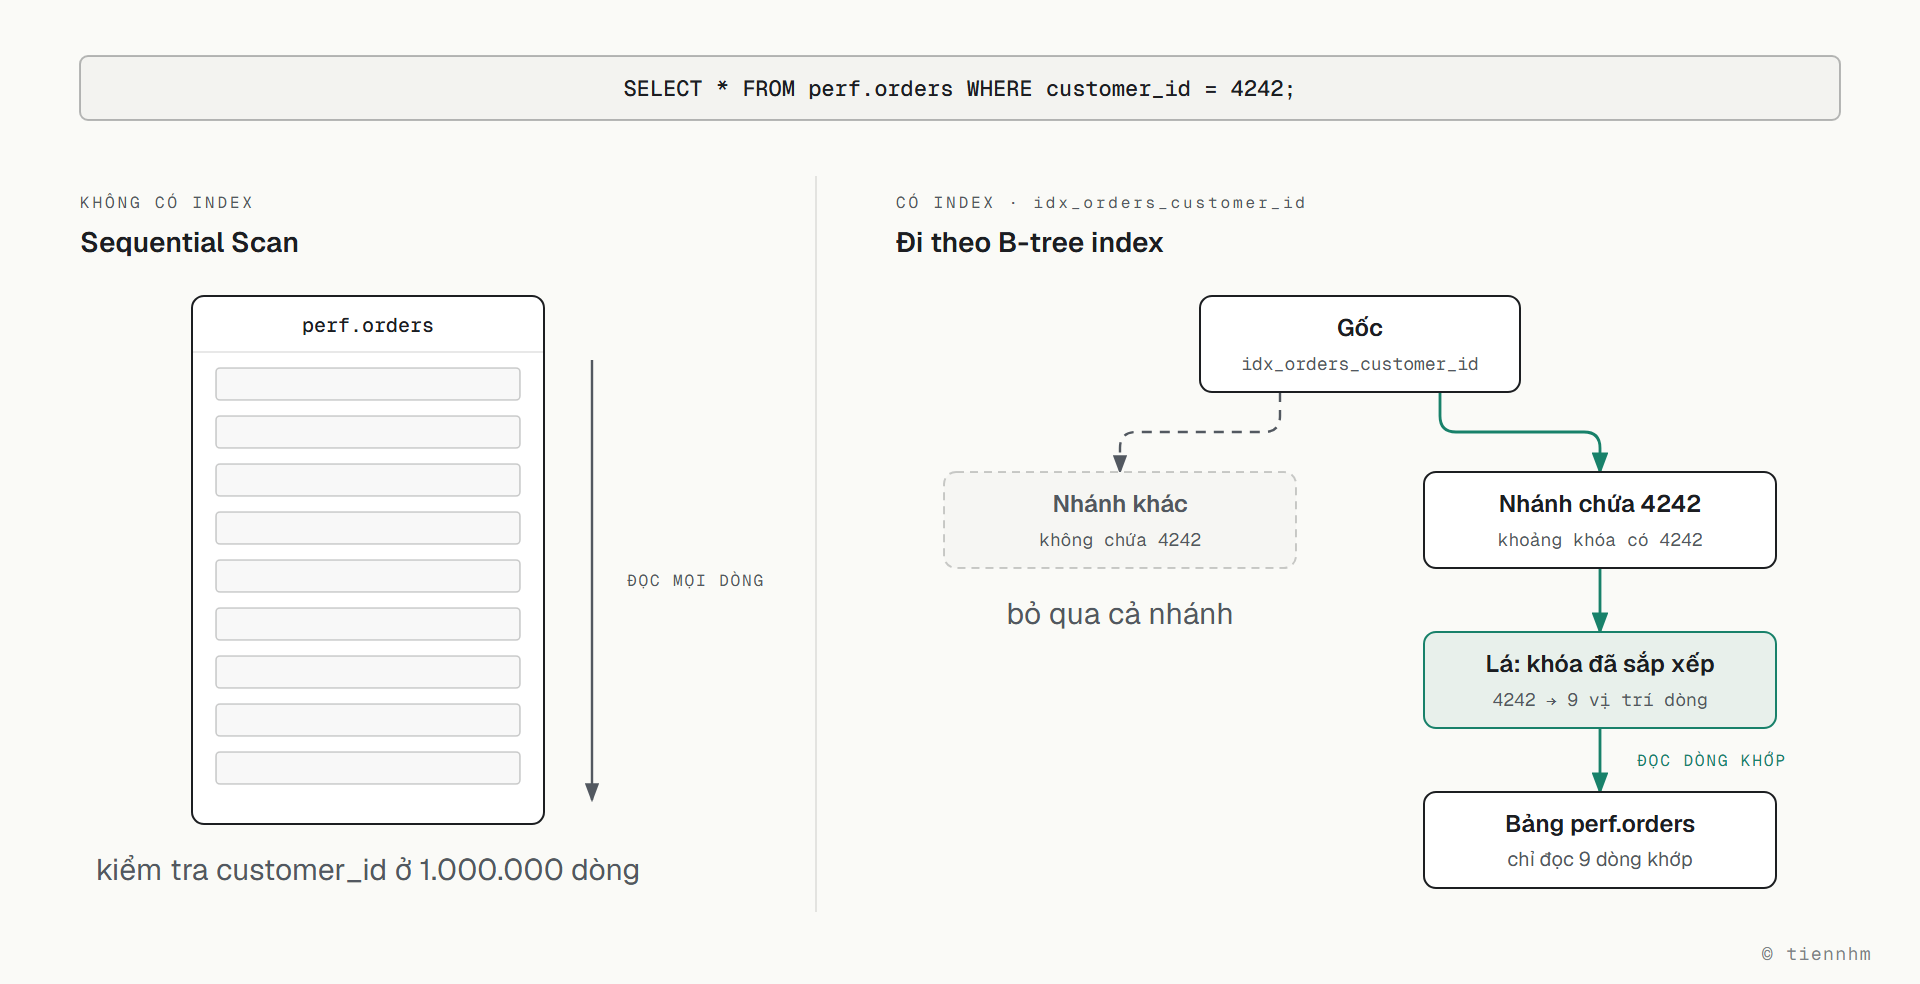
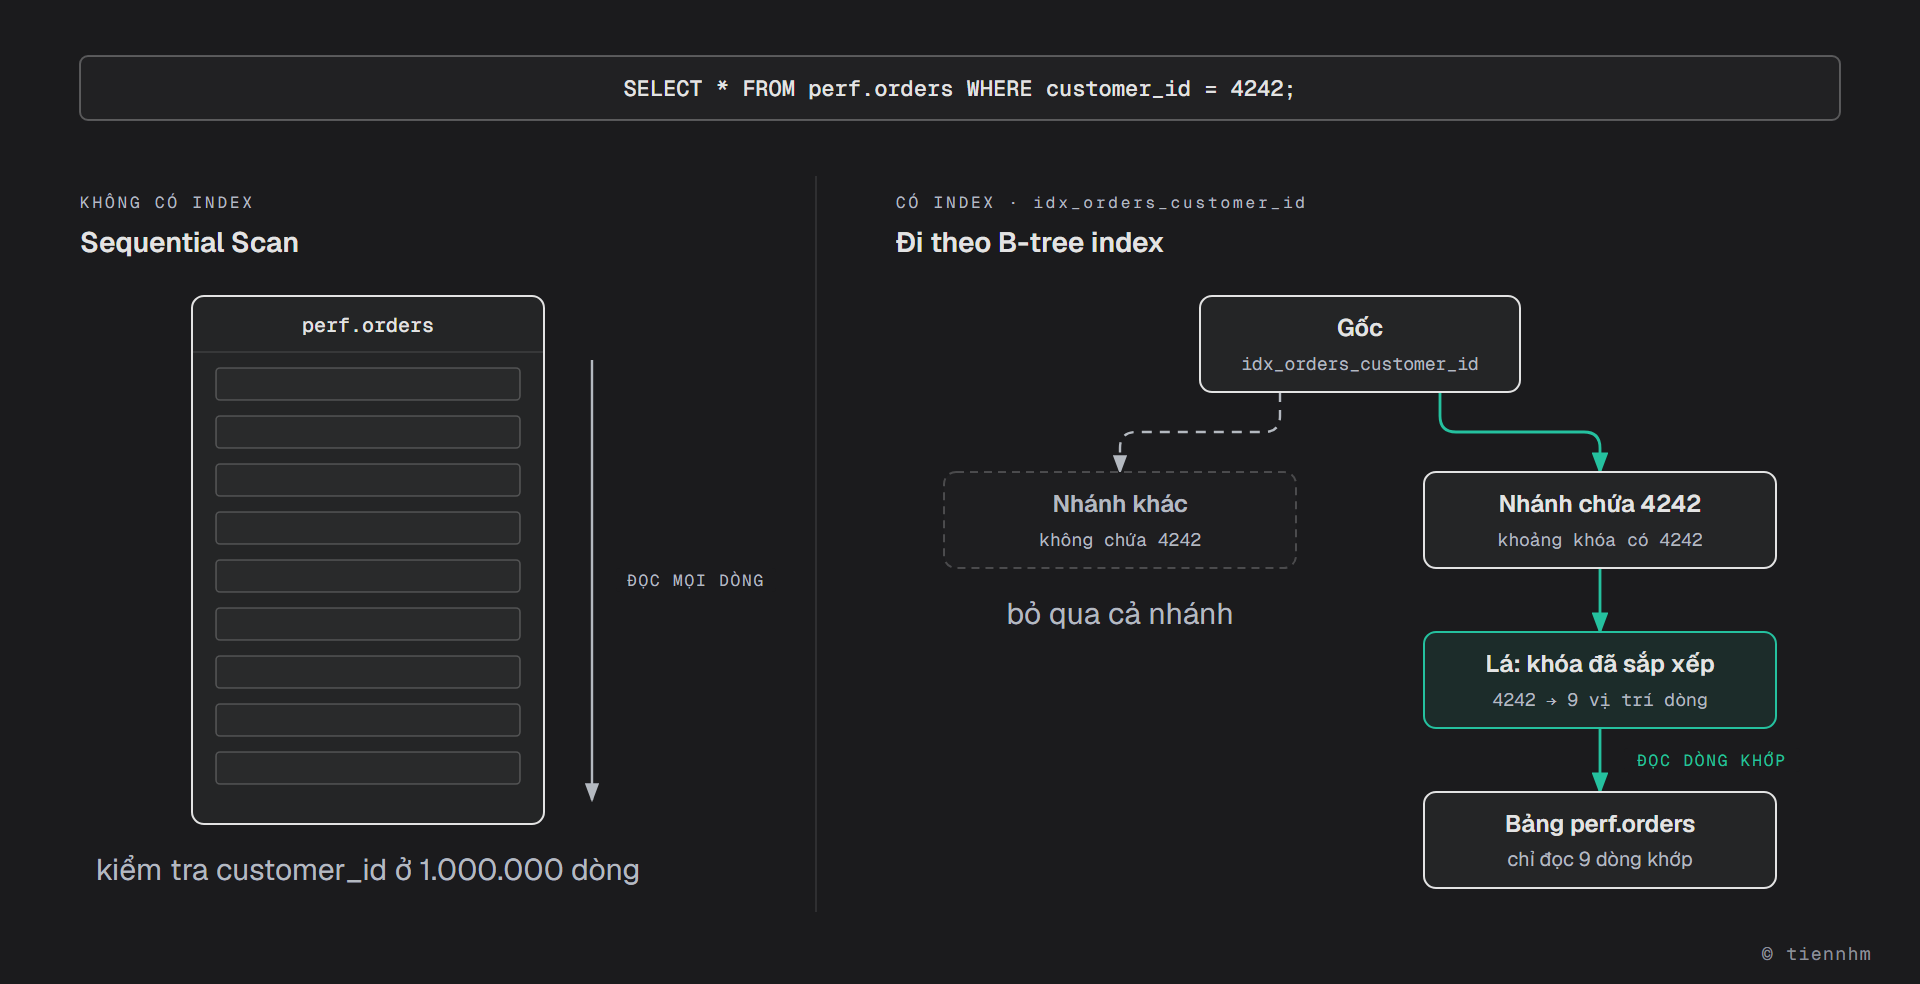
B-tree phục vụ được các phép so sánh =, <, <=, >, >=, BETWEEN, IN, IS NULL, LIKE 'abc%' (tìm theo tiền tố, có điều kiện, xem Ngày 28), và cả ORDER BY trên cột đó (vì dữ liệu trong index đã sắp xếp).
Chuẩn bị: bảng đủ lớn để đo
Bảng shop.orders chỉ có 40 dòng, quá nhỏ để thấy khác biệt. Bài này dùng schema perf: perf.customers (100.000 khách) và perf.orders (1.000.000 đơn). Nếu chưa có, chạy setup/perf_seed.sql theo hướng dẫn ở setup/README.md.
Lúc mới tạo, mỗi bảng perf chỉ có index của khóa chính:
SELECT indexname FROM pg_indexes WHERE schemaname = 'perf';| indexname |
|---|
| customers_pkey |
| orders_pkey |
Quy ước cho cả bài:
- Mỗi ví dụ bắt đầu từ trạng thái gốc ở trên. Ví dụ nào tạo index thì cuối ví dụ có
DROP INDEXđể trả lại trạng thái cũ. Nếu bạn bỏ qua bước xóa, kết quả của ví dụ sau có thể khác bài. - Để plan gọn và dễ so sánh, ta tắt chế độ chạy song song trong phiên làm việc (Ngày 20 sẽ giải thích chạy song song là gì). Lệnh
SETchỉ có hiệu lực trong phiên hiện tại: trongpsqlchạy một lần là đủ; trong Adminer hãy dán nó cùng ô lệnh với truy vấn.
SET max_parallel_workers_per_gather = 0;- Thời gian in trong bài là số đo thật trên máy của tác giả (PostgreSQL 16 trong Docker, máy đang chạy nhiều việc khác). Trên máy bạn con số sẽ khác, kể cả giữa hai lần chạy liên tiếp. Điều cần so sánh là cỡ chênh lệch (gấp vài lần hay vài trăm lần) và kiểu plan.
Đo trước và sau khi tạo index
EXPLAIN ANALYZE đặt trước một câu truy vấn sẽ chạy thật câu đó rồi in ra kế hoạch thực thi (plan): PostgreSQL đã đọc dữ liệu bằng cách nào và mất bao lâu. Hôm nay ta chỉ cần nhìn ba thứ: tên thao tác ở dòng đầu (Seq Scan hay có chữ Index), dòng Rows Removed by Filter, và Execution Time. Cách đọc đầy đủ từng con số là nội dung của Ngày 20.
Tìm các đơn của khách 4242, khi chưa có index trên customer_id:
EXPLAIN ANALYZE
SELECT * FROM perf.orders WHERE customer_id = 4242; QUERY PLAN
--------------------------------------------------------------------------------------------------------
Seq Scan on orders (cost=0.00..20697.00 rows=11 width=31) (actual time=2.798..100.092 rows=9 loops=1)
Filter: (customer_id = 4242)
Rows Removed by Filter: 999991
Planning Time: 0.245 ms
Execution Time: 100.207 msPostgreSQL đọc cả 1.000.000 dòng (Seq Scan), bỏ đi 999.991 dòng không khớp để giữ lại 9 dòng, mất khoảng 100 ms.
Tạo index rồi chạy lại đúng câu đó:
CREATE INDEX idx_orders_customer_id ON perf.orders (customer_id);CREATE INDEX
Time: 2128.251 ms (00:02.128)EXPLAIN ANALYZE
SELECT * FROM perf.orders WHERE customer_id = 4242; QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------
Bitmap Heap Scan on orders (cost=4.51..47.44 rows=11 width=31) (actual time=0.056..0.138 rows=9 loops=1)
Recheck Cond: (customer_id = 4242)
Heap Blocks: exact=9
-> Bitmap Index Scan on idx_orders_customer_id (cost=0.00..4.51 rows=11 width=0) (actual time=0.038..0.039 rows=9 loops=1)
Index Cond: (customer_id = 4242)
Planning Time: 0.293 ms
Execution Time: 0.164 msTừ khoảng 100 ms xuống khoảng 0,16 ms. Plan bây giờ có hai tầng: Bitmap Index Scan on idx_orders_customer_id tra index để lấy vị trí 9 dòng, rồi Bitmap Heap Scan đọc đúng 9 khối dữ liệu đó (Heap Blocks: exact=9). Đây là một biến thể của việc dùng index; PostgreSQL có ba cách dùng index (Index Scan, Index Only Scan, Bitmap Scan) và tự chọn cách rẻ nhất, Ngày 20 sẽ so sánh chúng. Điều quan trọng: không còn dòng Rows Removed by Filter: 999991.
Để ý: tạo index mất hơn 2 giây, vì PostgreSQL phải đọc cả bảng và sắp xếp 1 triệu giá trị. Trên bảng thật đang phục vụ người dùng, CREATE INDEX còn khóa không cho ghi vào bảng trong lúc tạo; khi đó người ta dùng CREATE INDEX CONCURRENTLY (chậm hơn nhưng không chặn ghi).
Liệt kê, xem kích thước và xóa index
SELECT indexname, indexdef
FROM pg_indexes
WHERE schemaname = 'perf' AND tablename = 'orders';| indexname | indexdef |
|---|---|
| orders_pkey | CREATE UNIQUE INDEX orders_pkey ON perf.orders USING btree (order_id) |
| idx_orders_customer_id | CREATE INDEX idx_orders_customer_id ON perf.orders USING btree (customer_id) |
Trong psql, \di perf.* cho danh sách tương tự, còn \d perf.orders in index ở cuối phần mô tả bảng.
Index là dữ liệu thật, chiếm chỗ trên đĩa:
SELECT pg_size_pretty(pg_relation_size('perf.orders'))                 AS bang_orders,
pg_size_pretty(pg_relation_size('perf.idx_orders_customer_id')) AS index_customer_id;| bang_orders | index_customer_id |
|---|---|
| 64 MB | 9088 kB |
Xóa index (dữ liệu trong bảng không bị ảnh hưởng):
DROP INDEX perf.idx_orders_customer_id;Ghi chú dialect:
pg_indexesvà\dilà của PostgreSQL. MySQL xem index bằngSHOW INDEX FROM orders;và xóa bằngDROP INDEX ten_index ON orders;(phải ghi tên bảng). SQL Server dùngEXEC sp_helpindex 'orders';và cũng viếtDROP INDEX ten_index ON orders;.
Những index có sẵn
Bạn không cần (và không nên) tự tạo index cho khóa chính hay cột UNIQUE: PostgreSQL tự tạo một B-tree index để kiểm tra trùng. Xem bảng customers của DSC Shop:
\d customers Table "shop.customers"
Column | Type | Collation | Nullable | Default
-------------+--------------------------+-----------+----------+------------------------------
customer_id | integer | | not null | generated always as identity
full_name | character varying(100) | | not null |
email | character varying(255) | | |
phone | character varying(20) | | |
city | character varying(100) | | |
birth_date | date | | |
created_at | timestamp with time zone | | not null | now()
Indexes:
"customers_pkey" PRIMARY KEY, btree (customer_id)
"customers_email_key" UNIQUE CONSTRAINT, btree (email)
Referenced by:
TABLE "orders" CONSTRAINT "orders_customer_id_fkey" FOREIGN KEY (customer_id) REFERENCES customers(customer_id)customers_pkey sinh ra từ PRIMARY KEY, customers_email_key sinh ra từ UNIQUE. Ngược lại, khóa ngoại không tự có index trong PostgreSQL. Vì vậy file setup/init/01_schema.sql tạo tay bốn index cho các cột khóa ngoại hay dùng (products.category_id, orders.customer_id, order_items.product_id, payments.order_id). Mục Index cho khóa ngoại bên dưới đo xem thiếu chúng thì sao.
Index nhiều cột và quy tắc tiền tố trái
Index có thể gồm nhiều cột. Index (customer_id, order_date) sắp xếp dữ liệu giống danh bạ điện thoại xếp theo (họ, tên): trước hết theo customer_id, trong cùng một customer_id thì theo order_date.
CREATE INDEX idx_orders_customer_date ON perf.orders (customer_id, order_date);Lọc theo cả hai cột: index thu hẹp đúng 5 dòng cần lấy.
EXPLAIN ANALYZE
SELECT * FROM perf.orders
WHERE customer_id = 4242 AND order_date >= '2025-01-01'; Bitmap Heap Scan on orders (cost=4.48..24.18 rows=5 width=31) (actual time=0.033..0.040 rows=5 loops=1)
Recheck Cond: ((customer_id = 4242) AND (order_date >= '2025-01-01 00:00:00+07'::timestamp with time zone))
Heap Blocks: exact=5
-> Bitmap Index Scan on idx_orders_customer_date (cost=0.00..4.47 rows=5 width=0) (actual time=0.027..0.028 rows=5 loops=1)
Index Cond: ((customer_id = 4242) AND (order_date >= '2025-01-01 00:00:00+07'::timestamp with time zone))
Planning Time: 0.381 ms
Execution Time: 0.086 msLấy 3 đơn mới nhất của khách 4242: trong index, các đơn của khách 4242 đã nằm cạnh nhau và xếp theo ngày, nên PostgreSQL chỉ việc đọc ngược 3 mục cuối (Index Scan Backward), không cần sắp xếp.
EXPLAIN ANALYZE
SELECT * FROM perf.orders
WHERE customer_id = 4242
ORDER BY order_date DESC
LIMIT 3; Limit (cost=0.42..13.57 rows=3 width=31) (actual time=0.009..0.012 rows=3 loops=1)
-> Index Scan Backward using idx_orders_customer_date on orders (cost=0.42..48.62 rows=11 width=31) (actual time=0.007..0.010 rows=3 loops=1)
Index Cond: (customer_id = 4242)
Planning Time: 0.110 ms
Execution Time: 0.063 msNhưng chỉ lọc theo order_date thì index này không giúp được: các đơn ngày 10/10/2026 nằm rải rác trong index, mỗi customer_id một chỗ, giống như tìm mọi người tên "An" trong danh bạ xếp theo họ.
EXPLAIN ANALYZE
SELECT * FROM perf.orders
WHERE order_date >= '2026-10-10'; Seq Scan on orders (cost=0.00..20697.00 rows=1410 width=31) (actual time=0.139..52.737 rows=1424 loops=1)
Filter: (order_date >= '2026-10-10 00:00:00+07'::timestamp with time zone)
Rows Removed by Filter: 998576
Planning Time: 0.049 ms
Execution Time: 52.837 msDROP INDEX perf.idx_orders_customer_date;Quy tắc tiền tố trái (leftmost prefix): index (a, b, c) dùng hiệu quả được khi điều kiện lọc bắt đầu từ cột trái nhất: a, hoặc a và b, hoặc a, b và c. Lọc chỉ theo b hoặc c thì không. Hệ quả khi thiết kế:
- Cột hay lọc bằng
=đặt trước, cột lọc theo khoảng (>=,BETWEEN) hoặc dùng đểORDER BYđặt sau. - Đã có
(customer_id, order_date)thì index riêng(customer_id)gần như thừa (bài tập 6 sẽ kiểm chứng).
Độ chọn lọc: khi index không được dùng
Độ chọn lọc (selectivity) là tỷ lệ số dòng khớp điều kiện trên tổng số dòng. Điều kiện chỉ khớp vài dòng là có độ chọn lọc cao; khớp phần lớn bảng là có độ chọn lọc thấp. Cột status của perf.orders phân bố rất lệch:
SELECT status, COUNT(*) AS so_don
FROM perf.orders
GROUP BY status
ORDER BY so_don DESC;| status | so_don |
|---|---|
| delivered | 849692 |
| cancelled | 80409 |
| shipped | 39920 |
| paid | 20119 |
| pending | 9860 |
Tạo index trên status rồi thử hai giá trị:
CREATE INDEX idx_orders_status ON perf.orders (status);

EXPLAIN ANALYZE
SELECT * FROM perf.orders WHERE status = 'pending'; Bitmap Heap Scan on orders (cost=111.08..8840.95 rows=9633 width=31) (actual time=1.496..37.680 rows=9860 loops=1)
Recheck Cond: ((status)::text = 'pending'::text)
Heap Blocks: exact=5767
-> Bitmap Index Scan on idx_orders_status (cost=0.00..108.67 rows=9633 width=0) (actual time=0.669..0.670 rows=9860 loops=1)
Index Cond: ((status)::text = 'pending'::text)
Planning Time: 0.065 ms
Execution Time: 38.132 msEXPLAIN ANALYZE
SELECT * FROM perf.orders WHERE status = 'delivered'; Seq Scan on orders (cost=0.00..20697.00 rows=848267 width=31) (actual time=0.008..85.577 rows=849692 loops=1)
Filter: ((status)::text = 'delivered'::text)
Rows Removed by Filter: 150308
Planning Time: 0.064 ms
Execution Time: 114.513 msIndex có sẵn nhưng với 'delivered' PostgreSQL vẫn chọn Seq Scan, và đó là lựa chọn đúng: 85% số dòng khớp, nên đọc cả bảng một lượt từ đầu tới cuối rẻ hơn là tra index 850.000 lần rồi nhảy lung tung trong bảng. Bộ lập kế hoạch (planner) biết tỷ lệ này nhờ thống kê về dữ liệu (sẽ học ở Ngày 20).
Ngay cả với 'pending' (1% số dòng), 9.860 dòng nằm rải trên 5.767 khối dữ liệu, nên vẫn tốn khoảng 38 ms. Index trên cột chỉ có vài giá trị khác nhau như status, is_active, giới tính... hiếm khi đáng giá; mục tiếp theo có cách tốt hơn.
SELECT pg_size_pretty(pg_relation_size('perf.idx_orders_status')) AS kich_thuoc;
DROP INDEX perf.idx_orders_status;| kich_thuoc |
|---|
| 6896 kB |
Một trường hợp khác: bảng nhỏ. Bảng shop.orders có index orders_customer_id_idx, nhưng sau khi cập nhật thống kê bằng ANALYZE, PostgreSQL thấy cả bảng chỉ nằm trong 1 khối dữ liệu và chọn Seq Scan:
ANALYZE orders;
EXPLAIN ANALYZE
SELECT * FROM orders WHERE customer_id = 3; Seq Scan on orders (cost=0.00..1.50 rows=3 width=69) (actual time=0.007..0.009 rows=3 loops=1)
Filter: (customer_id = 3)
Rows Removed by Filter: 37
Planning Time: 0.038 ms
Execution Time: 0.016 msVậy "đã tạo index mà plan vẫn là Seq Scan" chưa chắc là lỗi. Hãy xem điều kiện khớp bao nhiêu phần trăm số dòng, và bảng lớn cỡ nào.
Partial index: chỉ index phần dữ liệu hay tìm
Màn hình "đơn chờ xử lý" của cửa hàng luôn hỏi các đơn pending cũ nhất. Chỉ 1% số đơn là pending, vậy không cần index cả triệu đơn: partial index (index một phần) chỉ chứa các dòng thỏa điều kiện WHERE khi tạo.
CREATE INDEX idx_orders_pending ON perf.orders (order_date)
WHERE status = 'pending';
SELECT pg_size_pretty(pg_relation_size('perf.idx_orders_pending')) AS kich_thuoc;| kich_thuoc |
|---|
| 232 kB |
Nhỏ hơn index trên status khoảng 30 lần (232 kB so với 6896 kB), và trả lời đúng câu hỏi của màn hình:
EXPLAIN ANALYZE
SELECT order_id, customer_id, order_date
FROM perf.orders
WHERE status = 'pending'
ORDER BY order_date
LIMIT 5; Limit (cost=0.29..13.02 rows=5 width=16) (actual time=0.019..0.027 rows=5 loops=1)
-> Index Scan using idx_orders_pending on orders (cost=0.29..24532.36 rows=9633 width=16) (actual time=0.018..0.025 rows=5 loops=1)
Planning Time: 0.174 ms
Execution Time: 0.037 msIndex chỉ dùng được khi điều kiện của truy vấn nằm gọn trong điều kiện của index. Hỏi đơn paid thì index này vô dụng:
EXPLAIN ANALYZE
SELECT order_id, customer_id, order_date
FROM perf.orders
WHERE status = 'paid'
ORDER BY order_date
LIMIT 5; Limit (cost=21024.76..21024.77 rows=5 width=16) (actual time=46.033..46.036 rows=5 loops=1)
-> Sort (cost=21024.76..21074.09 rows=19733 width=16) (actual time=46.032..46.033 rows=5 loops=1)
Sort Key: order_date
Sort Method: top-N heapsort Memory: 25kB
-> Seq Scan on orders (cost=0.00..20697.00 rows=19733 width=16) (actual time=0.008..44.098 rows=20119 loops=1)
Filter: ((status)::text = 'paid'::text)
Rows Removed by Filter: 979881
Planning Time: 0.045 ms
Execution Time: 46.051 msDROP INDEX perf.idx_orders_pending;Ghi chú dialect: SQL Server có tính năng tương tự gọi là filtered index (
CREATE INDEX ... WHERE ...). MySQL không hỗ trợ partial index.
Expression index và UNIQUE index
Người dùng gõ email lúc hoa lúc thường, nên ứng dụng thường tìm bằng lower(email). Nhưng index thường trên email lưu giá trị gốc, không lưu lower(email), nên điều kiện có hàm bọc quanh cột không dùng được nó. Chưa có index nào trên email:
EXPLAIN ANALYZE
SELECT customer_id, full_name
FROM perf.customers
WHERE lower(email) = '[email protected]'; Seq Scan on customers (cost=0.00..2661.00 rows=500 width=22) (actual time=1.627..61.878 rows=1 loops=1)
Filter: (lower((email)::text) = '[email protected]'::text)
Rows Removed by Filter: 99999
Planning Time: 0.128 ms
Execution Time: 61.894 msExpression index (index trên biểu thức) lưu sẵn kết quả của biểu thức. Thêm UNIQUE thì nó còn là một ràng buộc: không cho hai email chỉ khác nhau ở chữ hoa chữ thường.
CREATE UNIQUE INDEX idx_customers_email_lower ON perf.customers (lower(email));
EXPLAIN ANALYZE
SELECT customer_id, full_name
FROM perf.customers
WHERE lower(email) = '[email protected]'; Index Scan using idx_customers_email_lower on customers (cost=0.42..8.44 rows=1 width=22) (actual time=0.029..0.029 rows=1 loops=1)
Index Cond: (lower((email)::text) = '[email protected]'::text)
Planning Time: 0.166 ms
Execution Time: 0.042 msThử thêm một khách có email [email protected] (chỉ khác chữ hoa):
INSERT INTO perf.customers (customer_id, full_name, email, city, created_at)
VALUES (100001, 'Khách trùng email', '[email protected]', 'Huế', now());ERROR: duplicate key value violates unique constraint "idx_customers_email_lower"
DETAIL: Key (lower(email::text))=([email protected]) already exists.Ngược lại, index này chỉ phục vụ đúng biểu thức lower(email). Câu so sánh thẳng email = ... không dùng được nó:
EXPLAIN ANALYZE
SELECT customer_id, full_name
FROM perf.customers
WHERE email = '[email protected]'; Seq Scan on customers (cost=0.00..2411.00 rows=1 width=22) (actual time=0.198..4.257 rows=1 loops=1)
Filter: ((email)::text = '[email protected]'::text)
Rows Removed by Filter: 99999
Planning Time: 0.043 ms
Execution Time: 4.267 msDROP INDEX perf.idx_customers_email_lower;Bài học: index phải khớp với cách viết điều kiện. Ngày 28 sẽ học cách viết lại điều kiện để không cần bọc hàm quanh cột (gọi là viết điều kiện sargable).
Ghi chú dialect: MySQL hỗ trợ index trên biểu thức từ bản 8.0.13 (cú pháp hai lớp ngoặc:
CREATE INDEX ... ON customers ((lower(email)));). SQL Server không index thẳng biểu thức mà tạo cột tính toán (computed column) rồi index cột đó.
Chi phí ghi: index không miễn phí
Mỗi lần INSERT, PostgreSQL phải ghi dòng vào bảng và chèn một mục vào từng index của bảng (đúng vị trí đã sắp xếp). UPDATE cột có index và DELETE cũng tốn thêm việc tương tự. Đo bằng cách chép 200.000 đơn vào một bảng nháp, lần đầu không có index nào, lần sau có 4 index:
DROP TABLE IF EXISTS perf.orders_copy;
CREATE TABLE perf.orders_copy (LIKE perf.orders); -- chỉ chép cột, không chép index
\timing on
INSERT INTO perf.orders_copy SELECT * FROM perf.orders WHERE order_id <= 200000;
\timing off
TRUNCATE perf.orders_copy;
ALTER TABLE perf.orders_copy ADD PRIMARY KEY (order_id);
CREATE INDEX ON perf.orders_copy (customer_id, order_date);
CREATE INDEX ON perf.orders_copy (order_date);
CREATE INDEX ON perf.orders_copy (status);
\timing on
INSERT INTO perf.orders_copy SELECT * FROM perf.orders WHERE order_id <= 200000;
\timing off
SELECT pg_size_pretty(pg_table_size('perf.orders_copy')) AS du_lieu,
pg_size_pretty(pg_indexes_size('perf.orders_copy')) AS cac_index;
DROP TABLE perf.orders_copy;\timing là lệnh của psql, bật đo thời gian từng câu. Kết quả trên máy tác giả:
| Lần chèn 200.000 dòng | Thời gian |
|---|---|
| Không có index | 353 ms |
| Có khóa chính + 3 index | 3584 ms |
| du_lieu | cac_index |
|---|---|
| 13 MB | 19 MB |
Chèn chậm đi khoảng 10 lần, và các index còn chiếm nhiều chỗ hơn chính dữ liệu. Vì vậy:
- Chỉ tạo index cho truy vấn thật sự chạy thường xuyên và đang chậm, không tạo "cho chắc".
- Định kỳ xem index nào không ai dùng (cột
idx_scantrong viewpg_stat_user_indexescho biết số lần mỗi index được dùng) rồi xóa. - Khi nạp một lượng dữ liệu rất lớn vào bảng trống, có thể nạp trước rồi tạo index sau.
Index cho khóa ngoại
Khi xóa một khách hàng, PostgreSQL phải kiểm tra bảng orders xem còn đơn nào trỏ tới khách đó không (ràng buộc khóa ngoại). Nếu orders.customer_id không có index, mỗi lần kiểm tra là một lần quét cả bảng đơn hàng.
perf.orders.customer_id có khóa ngoại tới perf.customers nhưng chưa có index. Khách 5930 không có đơn nào nên xóa được. Bọc trong BEGIN ... ROLLBACK để không mất dữ liệu (EXPLAIN ANALYZE chạy thật câu DELETE):
BEGIN;
EXPLAIN ANALYZE
DELETE FROM perf.customers WHERE customer_id = 5930;
ROLLBACK; Delete on customers (cost=0.29..8.31 rows=0 width=0) (actual time=0.312..0.314 rows=0 loops=1)
-> Index Scan using customers_pkey on customers (cost=0.29..8.31 rows=1 width=6) (actual time=0.222..0.223 rows=1 loops=1)
Index Cond: (customer_id = 5930)
Planning Time: 0.251 ms
Trigger for constraint orders_customer_id_fkey: time=79.181 calls=1
Execution Time: 79.577 msTìm và xóa dòng khách chỉ mất 0,3 ms; gần như toàn bộ 79 ms nằm ở dòng Trigger for constraint orders_customer_id_fkey, tức bước kiểm tra khóa ngoại. Thêm index cho cột khóa ngoại rồi thử lại:
CREATE INDEX idx_orders_customer_id ON perf.orders (customer_id);
BEGIN;
EXPLAIN ANALYZE
DELETE FROM perf.customers WHERE customer_id = 5930;
ROLLBACK; Delete on customers (cost=0.29..8.31 rows=0 width=0) (actual time=0.057..0.057 rows=0 loops=1)
-> Index Scan using customers_pkey on customers (cost=0.29..8.31 rows=1 width=6) (actual time=0.033..0.035 rows=1 loops=1)
Index Cond: (customer_id = 5930)
Planning Time: 0.102 ms
Trigger for constraint orders_customer_id_fkey: time=0.399 calls=1
Execution Time: 0.485 msDROP INDEX perf.idx_orders_customer_id;Cột khóa ngoại cũng thường là cột dùng để JOIN (orders.customer_id = customers.customer_id), nên index cho khóa ngoại gần như luôn đáng tạo.
Ghi chú dialect: MySQL (InnoDB) tự tạo index cho cột khóa ngoại nếu chưa có. PostgreSQL và SQL Server thì không, bạn phải tự tạo.
Khi nào nên tạo index
| Nên cân nhắc tạo | Thường không đáng |
|---|---|
Cột hay lọc bằng = hoặc theo khoảng, điều kiện khớp ít dòng | Cột chỉ có vài giá trị (status, is_active) khi lọc giá trị phổ biến |
Cột khóa ngoại, cột dùng để JOIN | Bảng nhỏ (vài trăm, vài nghìn dòng) |
ORDER BY ... LIMIT n chạy thường xuyên | Bảng ghi rất nhiều, đọc rất ít (ví dụ bảng log) |
| Điều kiện cố định hay hỏi trên một phần nhỏ dữ liệu (partial index) | Cột đã là cột đầu của một index nhiều cột khác |
Lỗi thường gặp
1. Tạo index rồi kết luận "đã nhanh" mà không đo. Index chỉ có ích khi planner dùng nó. Luôn chạy EXPLAIN ANALYZE trước và sau.
-- Sai: tạo xong là xong
CREATE INDEX idx_orders_status ON perf.orders (status);
-- Đúng: kiểm tra truy vấn thật có dùng index không (với 'delivered' thì không)
EXPLAIN ANALYZE
SELECT * FROM perf.orders WHERE status = 'delivered';
DROP INDEX perf.idx_orders_status;2. Sai thứ tự cột trong index nhiều cột. Truy vấn hay chạy là "đơn của một khách, mới nhất trước" mà tạo index (order_date, customer_id) thì điều kiện customer_id = 4242 không phải tiền tố trái. Đúng: (customer_id, order_date).
3. Bọc hàm quanh cột có index. WHERE lower(email) = ... không dùng index thường trên email. Hoặc tạo expression index đúng biểu thức, hoặc viết lại điều kiện (Ngày 28).
4. Tạo index cho mọi cột "cho chắc". Mỗi index làm chậm INSERT/UPDATE/DELETE và tốn dung lượng (bảng chép ở trên: 13 MB dữ liệu, 19 MB index).
5. Tự tạo index trùng với khóa chính hoặc UNIQUE. CREATE INDEX ON customers (customer_id) tạo thêm một bản sao vô ích của customers_pkey.
6. Quên xóa index tạo thử. Index thử nghiệm bị bỏ quên vẫn làm chậm mọi lần ghi. Sau khi thử, DROP INDEX.
Bài tập
Mọi bài tập chạy trên schema perf (trừ bài 1), bắt đầu từ trạng thái chỉ có khóa chính, và nhớ SET max_parallel_workers_per_gather = 0; để plan giống đáp án. Thời gian trên máy bạn sẽ khác, hãy so sánh kiểu plan và cỡ chênh lệch.
Cơ bản
Bài 1. Liệt kê các index của bảng shop.order_items. Mỗi index sinh ra từ đâu (khóa chính, UNIQUE hay tạo tay)? Bảng có khóa ngoại order_id, vì sao không cần tạo thêm index riêng cho order_id?
Đáp án
SELECT indexname, indexdef
FROM pg_indexes
WHERE schemaname = 'shop' AND tablename = 'order_items';
Kết quả:
| indexname | indexdef |
|---|---|
| order_items_pkey | CREATE UNIQUE INDEX order_items_pkey ON shop.order_items USING btree (order_id, product_id) |
| order_items_product_id_idx | CREATE INDEX order_items_product_id_idx ON shop.order_items USING btree (product_id) |
order_items_pkey sinh ra từ khóa chính (order_id, product_id). order_items_product_id_idx được tạo tay trong 01_schema.sql cho khóa ngoại product_id. Khóa ngoại order_id không cần index riêng vì nó là cột đầu (tiền tố trái) của index khóa chính.
Bài 2. Đo câu tìm khách theo email [email protected] trên perf.customers trước và sau khi tạo một UNIQUE index trên email. Ghi lại kiểu plan và thời gian. Xóa index sau khi xong.
Đáp án
EXPLAIN ANALYZE
SELECT customer_id, full_name, city
FROM perf.customers
WHERE email = '[email protected]';

CREATE UNIQUE INDEX idx_customers_email ON perf.customers (email);

EXPLAIN ANALYZE
SELECT customer_id, full_name, city
FROM perf.customers
WHERE email = '[email protected]';

SELECT customer_id, full_name, city
FROM perf.customers
WHERE email = '[email protected]';

DROP INDEX perf.idx_customers_email;
Kết quả (máy tác giả):
| Plan | Execution Time | |
|---|---|---|
| Trước | Seq Scan on customers, Rows Removed by Filter: 99999 | 6.848 ms |
| Sau | Index Scan using idx_customers_email on customers | 0.060 ms |
| customer_id | full_name | city |
|---|---|---|
| 77777 | Khách hàng 77777 | Hải Phòng |
Vận dụng
Bài 3. Giả sử có index (status, order_date) trên perf.orders. Dự đoán câu nào dưới đây dùng được index, rồi kiểm chứng bằng EXPLAIN (không cần ANALYZE):
- (a)
WHERE status = 'pending' AND order_date >= '2026-10-01' - (b)
WHERE status = 'pending' - (c)
WHERE order_date >= '2026-10-10' - (d)
WHERE status = 'pending' ORDER BY order_date DESC LIMIT 10
Đáp án
CREATE INDEX idx_orders_status_date ON perf.orders (status, order_date);

EXPLAIN SELECT * FROM perf.orders WHERE status = 'pending' AND order_date >= '2026-10-01';
EXPLAIN SELECT * FROM perf.orders WHERE status = 'pending';
EXPLAIN SELECT * FROM perf.orders WHERE order_date >= '2026-10-10';
EXPLAIN SELECT * FROM perf.orders WHERE status = 'pending' ORDER BY order_date DESC LIMIT 10;

DROP INDEX perf.idx_orders_status_date;
Kết quả:
| Câu | Dòng đầu của plan | Dùng index? |
|---|---|---|
| (a) | Index Scan using idx_orders_status_date on orders (cost=0.42..217.79 rows=75 width=31) | Có, cả hai cột |
| (b) | Bitmap Heap Scan on orders → Bitmap Index Scan on idx_orders_status_date | Có, cột đầu |
| (c) | Seq Scan on orders (cost=0.00..20697.00 rows=1410 width=31) | Không: order_date không phải tiền tố trái |
| (d) | Limit → Index Scan Backward using idx_orders_status_date | Có, và không cần sắp xếp |
Bài 4. Báo cáo "đơn bị hủy trong tháng 9/2026" chạy mỗi ngày:
SELECT order_id, customer_id, total_amount
FROM perf.orders
WHERE status = 'cancelled'
  AND order_date >= '2026-09-01' AND order_date < '2026-10-01';
Thiết kế một partial index cho báo cáo này, đo trước và sau, cho biết kích thước index.
Đáp án
EXPLAIN ANALYZE
SELECT order_id, customer_id, total_amount
FROM perf.orders
WHERE status = 'cancelled'
  AND order_date >= '2026-09-01' AND order_date < '2026-10-01';

CREATE INDEX idx_orders_cancelled ON perf.orders (order_date)
WHERE status = 'cancelled';

EXPLAIN ANALYZE
SELECT order_id, customer_id, total_amount
FROM perf.orders
WHERE status = 'cancelled'
  AND order_date >= '2026-09-01' AND order_date < '2026-10-01';

SELECT pg_size_pretty(pg_relation_size('perf.idx_orders_cancelled'));

DROP INDEX perf.idx_orders_cancelled;
Kết quả (máy tác giả):
| Plan | Execution Time | |
|---|---|---|
| Trước | Seq Scan on orders, Rows Removed by Filter: 998283 | 45.380 ms |
| Sau | Bitmap Index Scan on idx_orders_cancelled → Bitmap Heap Scan, 1717 dòng | 3.849 ms |
Index chỉ chứa khoảng 80.000 đơn bị hủy nên chỉ nặng 1776 kB. Trong plan sau, Index Cond chỉ còn điều kiện ngày: điều kiện status = 'cancelled' đã được index đảm bảo.
Bài 5. Ô tìm kiếm khách hàng cho phép gõ tên không phân biệt hoa thường, ứng dụng gửi câu WHERE lower(full_name) = 'khách hàng 4242'. Tạo index phù hợp trên perf.customers và đo trước, sau.
Đáp án
EXPLAIN ANALYZE
SELECT customer_id, full_name FROM perf.customers WHERE lower(full_name) = 'khách hàng 4242';

CREATE INDEX idx_customers_name_lower ON perf.customers (lower(full_name));

EXPLAIN ANALYZE
SELECT customer_id, full_name FROM perf.customers WHERE lower(full_name) = 'khách hàng 4242';

DROP INDEX perf.idx_customers_name_lower;
Kết quả (máy tác giả):
| Plan | Execution Time | |
|---|---|---|
| Trước | Seq Scan on customers, Filter: (lower((full_name)::text) = 'khách hàng 4242'::text) | 22.083 ms |
| Sau | Bitmap Index Scan on idx_customers_name_lower → Bitmap Heap Scan | 0.037 ms |
Tên có thể trùng (hai người cùng tên) nên đây là index thường, không phải UNIQUE.
Thử thách
Bài 6. Một đồng nghiệp đã tạo cả hai index (customer_id) và (customer_id, order_date) trên perf.orders. Index nào thừa? Chứng minh bằng cách xem kích thước hai index, xóa index thừa, rồi kiểm tra câu WHERE customer_id = 4242 vẫn dùng index.
Đáp án
CREATE INDEX idx_orders_customer_id ON perf.orders (customer_id);
CREATE INDEX idx_orders_customer_date ON perf.orders (customer_id, order_date);

SELECT indexrelid::regclass AS ten_index,
       pg_size_pretty(pg_relation_size(indexrelid)) AS kich_thuoc
FROM pg_index
WHERE indrelid = 'perf.orders'::regclass;

DROP INDEX perf.idx_orders_customer_id;

EXPLAIN SELECT * FROM perf.orders WHERE customer_id = 4242;

DROP INDEX perf.idx_orders_customer_date;
Kết quả:
| ten_index | kich_thuoc |
|---|---|
| perf.orders_pkey | 21 MB |
| perf.idx_orders_customer_id | 9088 kB |
| perf.idx_orders_customer_date | 30 MB |
 Bitmap Heap Scan on orders  (cost=4.51..47.44 rows=11 width=31)
   Recheck Cond: (customer_id = 4242)
   ->  Bitmap Index Scan on idx_orders_customer_date  (cost=0.00..4.51 rows=11 width=0)
         Index Cond: (customer_id = 4242)
(customer_id) là tiền tố trái của (customer_id, order_date), nên index một cột là thừa: xóa đi tiết kiệm 9 MB và bớt một index phải cập nhật mỗi lần ghi, trong khi câu lọc theo customer_id vẫn dùng index hai cột. (Index một cột nhỏ hơn hẳn vì PostgreSQL gộp các khóa trùng nhau; index hai cột ít khóa trùng hơn nên không gộp được nhiều.)
Bài 7. Không chạy thử, hãy giải thích vì sao với index idx_orders_status trên perf.orders(status), câu WHERE status = 'delivered' vẫn dùng Seq Scan nhưng câu WHERE status = 'pending' lại dùng index. Nếu cửa hàng có thêm trạng thái refunded chiếm 0,1% số đơn và thường xuyên tra cứu, bạn sẽ tạo index nào?
Đáp án
'delivered' khớp khoảng 85% bảng (849.692/1.000.000 dòng). Đọc cả bảng một lượt rẻ hơn tra index hàng trăm nghìn lần rồi nhảy qua lại trong bảng, nên planner chọn Seq Scan. 'pending' chỉ khớp khoảng 1% nên tra index rẻ hơn. Planner biết các tỷ lệ này nhờ thống kê của bảng (Ngày 20).
Với trạng thái hiếm refunded hay được tra cứu, hợp lý nhất là partial index, ví dụ CREATE INDEX ON perf.orders (order_date) WHERE status = 'refunded';: rất nhỏ, chỉ cập nhật khi có đơn refunded, và còn giúp sắp xếp theo ngày. (Bảng hiện không có trạng thái này nên không có kết quả để chạy.)
Tóm tắt
- Index là cấu trúc phụ lưu giá trị cột đã sắp xếp kèm vị trí dòng; mặc định là B-tree, phục vụ
=, so sánh khoảng vàORDER BY. - Luôn đo bằng
EXPLAIN ANALYZEtrước và sau; xóa index tạo thử bằngDROP INDEX. - Khóa chính và UNIQUE tự có index; khóa ngoại thì không, hãy tự tạo.
- Index nhiều cột tuân theo quy tắc tiền tố trái:
(a, b)giúp lọc theoahoặcavàb, không giúp lọc chỉ theob. - Độ chọn lọc quyết định index có được dùng: điều kiện khớp phần lớn bảng hoặc bảng nhỏ thì Seq Scan là lựa chọn đúng.
- Partial index cho phần dữ liệu hay hỏi; expression index cho điều kiện có hàm; UNIQUE index vừa tăng tốc vừa chặn trùng.
- Mỗi index làm chậm thao tác ghi và tốn dung lượng: chỉ tạo khi có truy vấn thật cần.
Đọc thêm
- Có index rồi mà truy vấn vẫn quét toàn bảng? Sargability và một hàm bọc quanh cột — Cột đã có index, câu WHERE lọc đúng cột đó, nhưng execution plan vẫn là Seq Scan.
- Thêm 4 index làm INSERT chậm 6 lần: cái giá không ai nhắc khi bảo bạn đánh index — Mọi hướng dẫn tối ưu đều bảo thêm index, rất ít bài nói về hoá đơn.
- Tài liệu PostgreSQL: Indexes.
⬅️ Ngày 14: Ôn tập 2 - Báo cáo trên DSC Shop | 📚 Mục lục | Ngày 16: Transaction và ACID ➡️